Radar Telegram alerts Ouvrir Radar

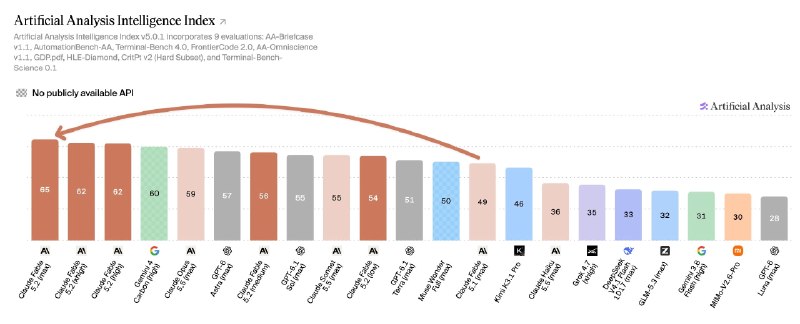
L'analyse artificielle place le Claude Fable 5.2 à travers son benchmark : 65 points et première place, 5 au dessus du Gemini 4 Carbon et 6 au dessus de l'Opus 5.5.

תרגם לעברית

Нейроканал (RU) · · Source

L'analyse artificielle place le Claude Fable 5.2 à travers son benchmark : 65 points et première place, 5 au dessus du Gemini 4 Carbon et 6 au dessus de l'Opus 5.5.

L'analyse artificielle place le Claude Fable 5.2 à travers son benchmark : 65 points et première place, 5 au dessus du Gemini 4 Carbon et 6 au dessus de l'Opus 5.5.

Le modèle est le plus solide en matière de science et de connaissances. Il n'y a pas d'écart dans les performances des agents : dans Terminal-Bench 4.0, il a les mêmes 60 % que Opus 5.5, et Kimi K3.1 Pro, Gemini 4 Carbon et Sonata 5.5 sont en avance.

Max Mission coûte 26,5 $, soit 2,6 fois plus cher que l'opus 5.5. High est plus rentable : 62 points, plus que tout autre modèle, et environ 9 $ par mission. Les collègues ont regardé de plus près.

Plus sur Radar

Envie de voir tous les signalements en temps réel ?

Des centaines de sources dans le monde, traduites dans votre langue, avec des alertes sur ce qui compte pour vous.

Inscription gratuite
Share on WhatsApp Get alerts on Telegram