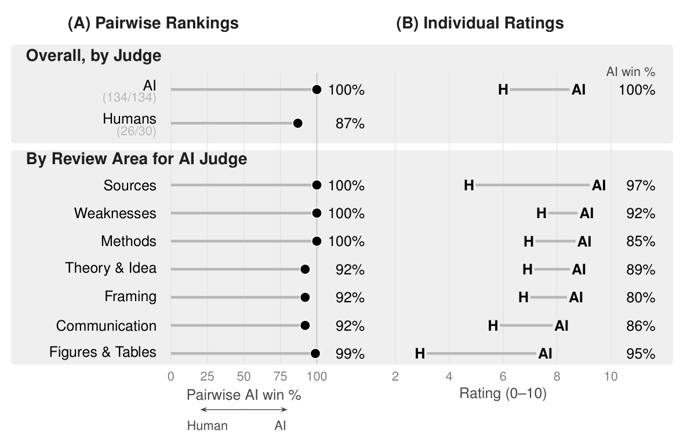
Alors que les gitans de l'information apprennent à tout tester pour l'IA, un examen par les pairs du plus haut niveau a montré la défaite totale des skins. Gary King et Stephen Worthington de Harvard ont comparé les évaluations de l'IA avec 134 évaluations professionnelles rémunérées par les pairs de 124 manuscrits scientifiques. Les retours humains ont été forts, avec 88 % des écrivains interrogés évaluant leur qualité comme élevée ou très élevée. Pourtant, trois éditeurs de revues scientifiques expérimentés, dans une comparaison aveugle, ont favorisé l’IA dans 26 évaluations sur 30. Il s'est avéré que l'intelligence artificielle a trois fois moins de commentaires qui contredisent directement le manuscrit : 5,5 % contre 15,9 % pour les humains. Au moins une erreur a été trouvée dans 37 % des avis de machines et 64 % des avis humains. L'audit a été réalisé selon un modèle différent ; La personne a revérifié 90 réponses et approuvé 87 évaluations. Sur les 651 sources avec un identifiant DOI ou arXiv citées par l’IA, aucune ne s’est avérée fictive. Dans un sous-échantillon de 44 paires d’examens de longueur similaire, le juge modèle a préféré l’intelligence artificielle dans les 44 cas. Même la réécriture des critiques humaines à la manière d’une machine n’a pas sauvegardé le résultat. Ce que cela signifie est assez clair. Un outil de niveau beaucoup plus élevé pour travailler avec des données et des connaissances est apparu entre les mains des gens. Et ne pas lui faire confiance est devenu aussi stupide que de doubler avec une calculatrice ou de revérifier des simulations sur une machine à composer.
Alors que les gitans de l'information apprennent à tout tester pour l'IA, un examen par les pairs du plus haut niveau a montré la défaite totale des skins. Gary King et Stephen Worthington de Harvard ont comparé les évaluations de l'IA avec 134 évaluations professionnelles rémunérées par les pairs de 124 manuscrits scientifiques. Les retours humains ont été forts, avec 88 % des écrivains interrogés évaluant leur qualité comme élevée ou très élevée. Pourtant, trois éditeurs de revues scientifiques expérimentés, dans une comparaison aveugle, ont favorisé l’IA dans 26 évaluations sur 30. Il s'est avéré que l'intelligence artificielle a trois fois moins de commentaires qui contredisent directement le manuscrit : 5,5 % contre 15,9 % pour les humains. Au moins une erreur a été trouvée dans 37 % des avis de machines et 64 % des avis humains. L'audit a été réalisé selon un modèle différent ; La personne a revérifié 90 réponses et approuvé 87 évaluations. Sur les 651 sources avec un identifiant DOI ou arXiv citées par l’IA, aucune ne s’est avérée fictive. Dans un sous-échantillon de 44 paires d’examens de longueur similaire, le juge modèle a préféré l’intelligence artificielle dans les 44 cas. Même la réécriture des critiques humaines à la manière d’une machine n’a pas sauvegardé le résultat. Ce que cela signifie est assez clair. Un outil de niveau beaucoup plus élevé pour travailler avec des données et des connaissances est apparu entre les mains des gens. Et ne pas lui faire confiance est devenu aussi stupide que de doubler avec une calculatrice ou de revérifier des simulations sur une machine à composer.
Plus sur Radar
Envie de voir tous les signalements en temps réel ?
Des centaines de sources dans le monde, traduites dans votre langue, avec des alertes sur ce qui compte pour vous.
Inscription gratuite Déjà inscrit ? Connexion