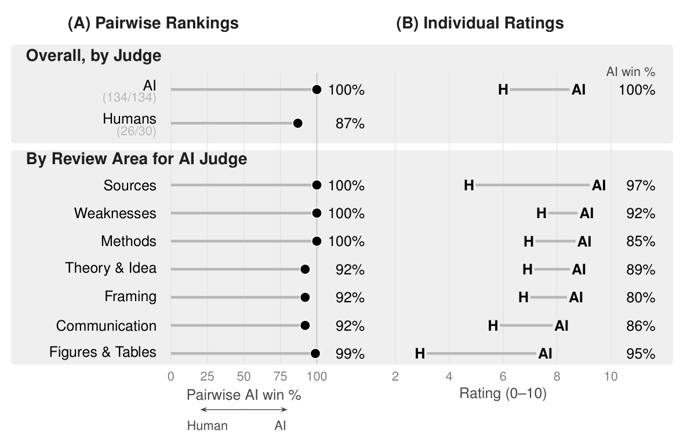
در حالی که به کولی های اطلاعاتی آموزش داده می شود که همه چیز را برای هوش مصنوعی آزمایش کنند، بررسی بالاترین سطح همتایان شکست کامل پوست ها را نشان داده است. گری کینگ و استفان ورتینگتون از هاروارد، بررسیهای هوش مصنوعی را با 134 بررسی حرفهای حرفهای از 124 نسخه خطی علمی مقایسه کردند. بازخورد انسانی قوی بود، به طوری که 88٪ از نویسندگان مورد بررسی کیفیت خود را بالا یا بسیار بالا ارزیابی کردند. با این حال، سه سردبیر مجلات علمی باتجربه، در مقایسه ای کورکورانه، در 26 مورد از 30 ارزیابی از هوش مصنوعی حمایت کردند. مشخص شد که هوش مصنوعی سه برابر کمتر نظراتی دارد که مستقیماً با نسخه خطی تناقض دارد: 5.5٪ در مقایسه با 15.9٪ برای انسان. حداقل یک خطا در 37٪ از بررسی های ماشین و 64٪ از بررسی های انسانی پیدا شد. ممیزی در مدل متفاوتی انجام شد. این شخص 90 پاسخ را دوباره بررسی کرد و 87 رتبه بندی را تأیید کرد. از 651 منبع با شناسه DOI یا arXiv که توسط هوش مصنوعی ذکر شده است، صفر آن ساختگی است. در یک نمونه فرعی از 44 جفت بررسی با طول مشابه، قاضی مدل هوش مصنوعی را در همه 44 مورد ترجیح داد. حتی بازنویسی نظرات انسانی به سبک ماشینی نتیجه را نجات نداد. کاملاً واضح است که معنی آن چیست. ابزار سطح بسیار بالاتری برای کار با داده ها و دانش در دستان مردم ظاهر شد. و اعتماد نکردن به او به احمقانه بودن دو برابر کردن با ماشین حساب یا بررسی دوبار شبیه سازی در یک ماشین ترکیبی تبدیل شده است.
در حالی که به کولی های اطلاعاتی آموزش داده می شود که همه چیز را برای هوش مصنوعی آزمایش کنند، بررسی بالاترین سطح همتایان شکست کامل پوست ها را نشان داده است. گری کینگ و استفان ورتینگتون از هاروارد، بررسیهای هوش مصنوعی را با 134 بررسی حرفهای حرفهای از 124 نسخه خطی علمی مقایسه کردند. بازخورد انسانی قوی بود، به طوری که 88٪ از نویسندگان مورد بررسی کیفیت خود را بالا یا بسیار بالا ارزیابی کردند. با این حال، سه سردبیر مجلات علمی باتجربه، در مقایسه ای کورکورانه، در 26 مورد از 30 ارزیابی از هوش مصنوعی حمایت کردند. مشخص شد که هوش مصنوعی سه برابر کمتر نظراتی دارد که مستقیماً با نسخه خطی تناقض دارد: 5.5٪ در مقایسه با 15.9٪ برای انسان. حداقل یک خطا در 37٪ از بررسی های ماشین و 64٪ از بررسی های انسانی پیدا شد. ممیزی در مدل متفاوتی انجام شد. این شخص 90 پاسخ را دوباره بررسی کرد و 87 رتبه بندی را تأیید کرد. از 651 منبع با شناسه DOI یا arXiv که توسط هوش مصنوعی ذکر شده است، صفر آن ساختگی است. در یک نمونه فرعی از 44 جفت بررسی با طول مشابه، قاضی مدل هوش مصنوعی را در همه 44 مورد ترجیح داد. حتی بازنویسی نظرات انسانی به سبک ماشینی نتیجه را نجات نداد. کاملاً واضح است که معنی آن چیست. ابزار سطح بسیار بالاتری برای کار با داده ها و دانش در دستان مردم ظاهر شد. و اعتماد نکردن به او به احمقانه بودن دو برابر کردن با ماشین حساب یا بررسی دوبار شبیه سازی در یک ماشین ترکیبی تبدیل شده است.
بیشتر در Radar
میخواهید همه گزارشها را لحظهای ببینید؟
صدها منبع از سراسر جهان، ترجمهشده به زبان شما، با هشدار برای آنچه برایتان مهم است.
ثبتنام رایگان حساب دارید؟ ورود