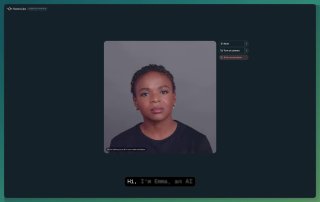
یکی دیگر از آواتارهای بلادرنگ. و به نظر می رسد که خوب است.
Nuance Labs یک مدل صوتی و تصویری تمام دوبلکس و آواتار Emma را منتشر می کند.
استارتآپ آمریکایی Nuance Labs که توسط محققان سابق اپل تأسیس شده است، مدل پایه صوتی و تصویری Nuflex 1.0 را توسعه داده و آواتار ویدیویی تعاملی Emma را برای عموم منتشر کرده است که قادر به انجام گفتوگوی طبیعی با یک شخص در زمان واقعی به طور مستقیم در مرورگر است.
بیشتر آواتارهای دیجیتال موجود بر اساس اصل واکی تاکی ساخته شده اند: صدا با استفاده از STT رونویسی می شود، به LLM منتقل می شود، با استفاده از TTS پخش می شود و سپس یک مدل جداگانه حرکات لب را فعال می کند.
این اتصال یک تاخیر 1.5-3 ثانیه ایجاد می کند که به همین دلیل آواتار با ظاهری لعاب یخ می زند و منتظر پایان چرخش است.
Noplex این لایه را با ترکیب ادراک و تولید صدا و تصویر در یک شبکه عصبی سرتاسر واحد حذف می کند: سیستم به طور مداوم لحن، مکث و نوسانات در صدای مخاطب را می خواند و به طور همزمان حالات و گفتار واقعی صورت را پخش می کند.
تفاوت اصلی بین آواتار Emma مبتنی بر نوپلکس، توانایی گوش دادن و پاسخگویی همزمان است. این مدل قادر به تکان دادن سر، لبخند زدن، دادن سیگنال های گوش دادن فعال ("آه-ها"، "من می بینم") و تغییر حالات چهره به طور مستقیم در حالی که کاربر در حال صحبت است، بدون انتظار برای مکث است.
در آزمایش کور Nuance Labs از نمونه 1785 سوال تستی، Noflex در 89٪ مواقع با سرعت پاسخگویی یک انسان زنده مطابقت داشت.
با کمال تعجب، Emma بدون ثبت نام یا حساب کاربری مستقیماً آنلاین در دسترس است و این شرکت دسترسی اولیه به Noplex Live API را برای توسعه دهندگان باز کرده است.
راه اندازی با فیلترهای امنیتی بازاریابی همراه است: اجرا توسط یک بازیگر واقعی مجوز داده می شود، جریان ها با واترمارک های اجباری مشخص می شوند و شبیه سازی مستقیم چهره ها و صدای اشخاص ثالث به شدت مسدود شده است.
app.nuancelabs.ai.