המדען הראשי של OpenAI רוצה שכל מעבדת בינה מלאכותית תסכים על קו שאף אחד מהם לא חוצה
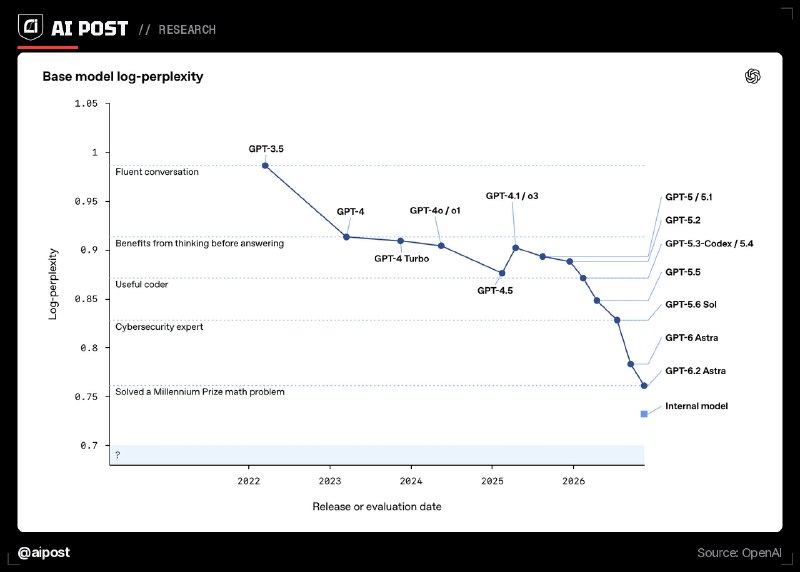
יאקוב פאצ'וקי מציע מגבלות משותפות שמעבדות לא יחצו עד שהיכולת להבין ולנטר התנהגות בינה מלאכותית תגיע לאבן דרך מוגדרת. כצעד ראשון, OpenAI פרסמה את המדד הפנימי שלה לגבי מידת היעילות של כל אחד מהמודלים הבסיסיים שלה מנבא טקסט מאז GPT-3.5.
נמוך יותר עדיף. מתחת ל-0.8, כישורי אבטחת סייבר ומתמטיקה המריאו. בערך ב-0.76 המודלים החלו להפיק תוצאות מתמטיות פורצות דרך, רמה שהטבלה מתווית "פתרו בעיה מתמטית בפרס המילניום". דגם פנימי שלא פורסם כבר יושב נמוך יותר מ-GPT-6.2 אסטרה.
פאצ'וקי מצפה ליותר "יכולות טרנספורמטיביות" בסביבות 0.68–0.7. "אני לא יודע מה יהיו היכולות האלה, וייתכן שלא נבחן אותן היום. "מחקר מונע בינה מלאכותית עשוי להביא למפולת של פריצות דרך באימונים כבר בשנת 2027, הוא אומר, וסביר שעבודת הבטיחות לא תעמוד בקצב.
סם אלטמן כינה את זה הדבר הכי חשוב ש-OpenAI פרסמה מזה זמן מה.