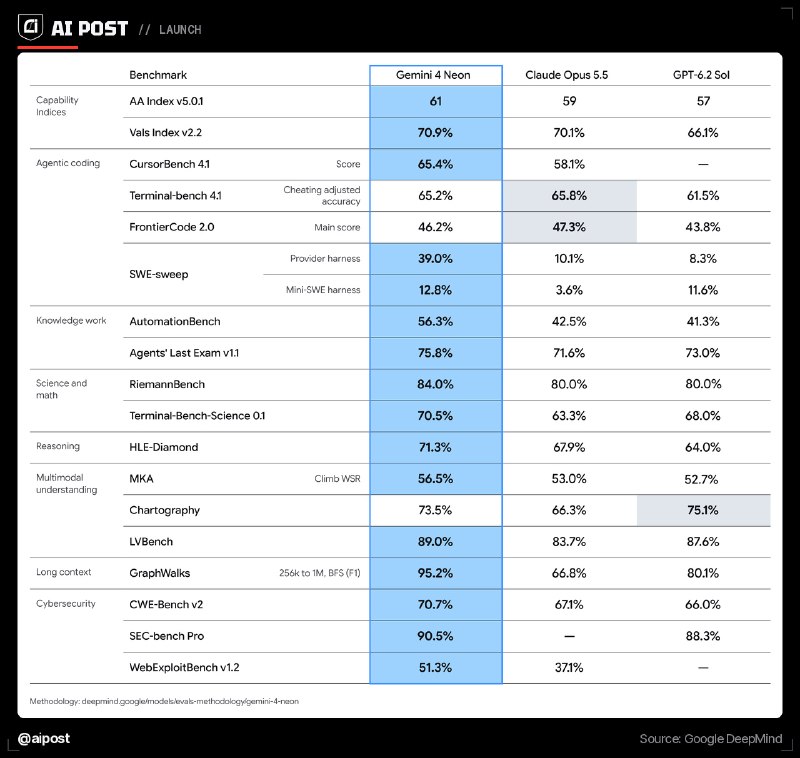
Le nouveau Gemini Gemini de Google bat Claude et OpenAI dans 16 tests sur 19, en comptant Gemini Twins 4 Neon déjà dans l'application Gemini pour les abonnés Google AI Pro et Ultra. Dans le classement de Google, il bat les Claude Opus 5.5 et GPT-6.2 Sol dans 16 des 19 tests, bien qu'un rival n'ait aucun score sur trois d'entre eux. Il perd deux épreuves de codage au profit de Claude et une épreuve de lecture au profit d'OpenAI. Les testeurs indépendants d'Artificial Analysis évaluent les GPT-6.2 Astra et Claude Fable 5.2, plus grands et plus lents. En tant qu'agent de codage, il a atteint un niveau avec Claude Opus 5.5 pour environ la moitié du coût par tâche : 6,86 $ par rapport à et #036 ; 1261, en comptant la chirurgie artificielle. Le modèle Dam 4 de Google en sept semaines. Les développeurs paient 3 millions de jetons et 15 par million de production. Les termes :
Le nouveau Gemini Gemini de Google bat Claude et OpenAI dans 16 tests sur 19, en comptant Gemini Twins 4 Neon déjà dans l'application Gemini pour les abonnés Google AI Pro et Ultra. Dans le classement de Google, il bat les Claude Opus 5.5 et GPT-6.2 Sol dans 16 des 19 tests, bien qu'un rival n'ait aucun score sur trois d'entre eux. Il perd deux épreuves de codage au profit de Claude et une épreuve de lecture au profit d'OpenAI. Les testeurs indépendants d'Artificial Analysis évaluent les GPT-6.2 Astra et Claude Fable 5.2, plus grands et plus lents. En tant qu'agent de codage, il a atteint un niveau avec Claude Opus 5.5 pour environ la moitié du coût par tâche : 6,86 $ par rapport à et #036 ; 1261, en comptant la chirurgie artificielle. Le modèle Dam 4 de Google en sept semaines. Les développeurs paient 3 millions de jetons et 15 par million de production. Les termes :
Plus sur Radar
Envie de voir tous les signalements en temps réel ?
Des centaines de sources dans le monde, traduites dans votre langue, avec des alertes sur ce qui compte pour vous.
Inscription gratuite Déjà inscrit ? Connexion